戦略編
第2回
AIオペレータの応対品質が担保できない──。多くのプロジェクトがPoC止まりになる根本原因は、ここにあります。今回は、AIオペレータの品質を大きく左右する要素であり、多くのコンタクトセンターがつまずくポイントでもある「ナレッジデータ」に焦点を当て、その管理の実態と「AI-Ready」なナレッジを実現する打ち手について解説します。
前回は、AIオペレータ導入プロジェクトが陥りやすい3つの罠「顧客体験の罠」「チューニングの罠」「ナレッジデータの罠」を解説しました。
あらためてその構造を整理すると、3つの罠のうち、とくに運用フェーズで影響が大きいのは後者の2つです。
チューニングの精度が上がらなければAIの応対精度は改善しませんし、そのチューニングの基盤となるのがナレッジデータです。そしてこの2つの品質が上がりきらないまま、本番運用に臨んだ場合、AIは顧客の問いに正確に答えられず、自己解決率は伸び悩みます。
「人件費削減のためにAIオペレータを入れたのに、肝心の応対品質が担保できない」。多くのプロジェクトがPoC止まりになる根本原因は、ここにあります。
そもそも、なぜナレッジデータがAIオペレータの品質を左右するのでしょうか。
LLM(大規模言語モデル)は、いわば膨大なデータで学習した「超優秀な新入社員」です。論理的思考力も文章力も高く、会話の流れを読む能力も申し分ない。しかし、どれほど優秀でも、入社初日で自社の商品仕様や規定、手続きのルールといったナレッジを知らなければ、顧客対応の現場に出すことはできません。「貴社のプランAとプランBの違いを教えてほしい」という顧客の問いに対し、業界の一般論でしか答えられないようでは、企業を代表する応対者として機能しないのです。
LLMにも同様のことが言えます。それ自体はどれほど賢くても、その企業・業界固有のコンテキストをナレッジとして与えていなければ、正確な応対はできません。ナレッジデータとは、AIオペレータに「この会社のこと」を教え込む唯一の手段です。だからこそ、ナレッジの品質がAIの応対品質に直接影響するのです。
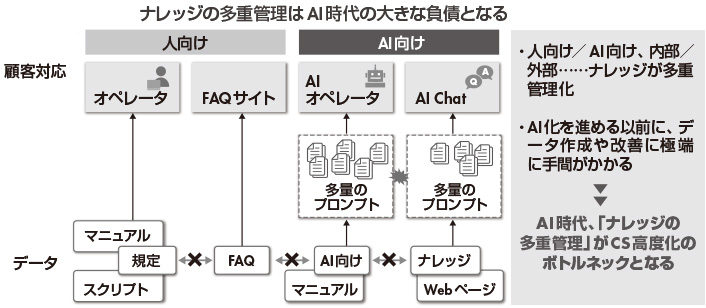
コンタクトセンターにおける「ナレッジ」であるFAQ、オペレータ向けトークスクリプト、商品マニュアル、社内規定──。これらは、企業規模によっては数千件、数万件とあることも珍しくありません。さらに、これらは目的やチャネルごとに分散して管理されているのが実態です。
具体的には、多くの現場では、FAQ向け・オペレータ向け・システム向けという複数の形式が、それぞれの担当者によって個別のツールで管理されています。ナレッジの品質に「満足している」と言える企業がほとんどない背景には、この「管理の分断」という問題が横たわっています。
そこにAIオペレータの導入検討が始まると、「AI向けナレッジ」という新たな形式の作成が加わります。既存の分断がさらに深まり、二重管理が三重、四重管理へと膨らんでいく(図1)。そして、ナレッジ管理の工数がかさみ、AIオペレータのチューニングもままならない。これが、ナレッジ管理の現実です。
AIコンタクトセンターの文脈で、「AI-Ready」なナレッジという言葉がよく使われるようになりました。しかし、その本質を正確に理解している現場は意外と少ないのではないでしょうか。
AI-Readyなナレッジが持つべき要素は、大きく2つに分けられます。
1つめは「AI-Readable」──AIが読める状態にすることです。人が読む前提で作られたナレッジは、画像だらけのPDF、複雑な分岐フローのトークスクリプトなど、AIにとって解釈しにくい形式が大半を占めます。これらのテキストを構造化し、画像には説明テキストを付与する。PDFをマークダウン化したり、表を構造化テキストに変換したりする、といった作業がAI-Readableに当たります。これはAI-Readyの前提となる基盤整備です。ただし、これだけでは十分ではありません。
2つめは、「どのナレッジをいつ引き出すべきか」という文脈が付与されているかどうか、というAI-Readyの本質です。
例えば、「契約変更」に関するナレッジが1つの企業で5〜10種類あったとします。ある顧客の問い合わせに対して、AIはどれを参照すべきでしょうか。どの商品の契約か、会員のステータスはどうか、どのような前提条件があるか。こうした切り分けに必要な情報は、多くの場合、末端のナレッジデータには記述されていません。
この状態でRAG(検索拡張生成)を使って類似度検索をかけてみると、「それっぽいけど違う」ナレッジを引いてきてしまうことが頻繁に起きます。顧客が「契約を変更したい」と言った瞬間、AIはキーワードに近い複数のナレッジをヒットさせますが、対象商品や会員区分によって適切な手続きは異なります。「その案内じゃない、こっちの手続きのはずだ」と顧客に感じさせる的外れな応対が、顧客体験を静かに傷つけていきます。
この文脈も含めた「マッチングのプロセス」を担うのが、ヒアリングフローとナレッジへのメタデータ付与です。「この問い合わせ意図に対してはこのナレッジを参照せよ」「この条件が満たされた場合のみ引き出せ」という情報をナレッジ側に付与しておくことで、AIは正確な根拠に基づいた応対ができるようになります。
顧客の第一声から問題ドメインを絞り込み、段階的なヒアリングで正確なナレッジに誘導する制御フロー、これがAI-Readyなナレッジの核心です。RAGの検索精度を上げることと、この制御フローを設計することは、本質的に別の問題です。どれほど高精度なRAGを導入しても、この設計がなければ、応対品質は安定しません。
こうした論理を頭では理解できても、実際にAI-Ready化の工数を目の当たりにすると、その重さに驚く担当者は少なくありません。
私たちが支援した顧客企業でも、次のようなケースがありました。AIコンタクトセンターへの移行を目指し、AIオペレータを全面展開した際、既存のオペレータ向けナレッジは約7000件ありました。この7000件をAI向けに変換・整備し、運用を開始するまでに相当の工数を要しました。加えて、運用開始後、AIの応対品質を改善しようとナレッジを修正するたびに、人(オペレータ)向けナレッジとの同期作業が発生。また、商品改定や規定変更があれば、オペレータが扱うマニュアルとAI向けナレッジの両方を更新しなければなりません。この更新を怠った瞬間、AI向けナレッジは陳腐化し、応対品質が低下します。
これは特殊なケースではなく、AI-Ready化に独力で取り組んだ多くの企業が直面する構造的な問題です。
ナレッジ管理を後回しにして設計すると品質が安定しない、かといって、しっかり作り込もうとすると管理の分断が深まる。どちらに転んでも行き詰まるこの構造こそが、「ナレッジデータの罠」の本質です。
では、どうすればよいのか。現場で効果が出ている2つのアプローチを提言します。
まず重要なのは、考え方を「完璧にAI-Ready化してから動かす」から、「AIオペレータを運用しながらナレッジを整えていく」へと転換することです。
多くの企業は、「まずナレッジを全部AI-Ready化してから、AIオペレータを立ち上げよう」という順序で進めようとします。しかし、AIオペレータを実際に動かす前にナレッジを設計しきろうとすると、どうしても机上の空論になりがちです。
「どのナレッジをどう構造化すべきか」「どのヒアリングフローが有効か」は、実際に顧客応対させてみて初めて見えてくることが多いです。準備を完璧にしてから始めようとすると、一歩も踏み出せないまま時間だけが過ぎていきます。
また、コンタクトセンター全体、すべてのコンタクトリーズンを一気にAI化しようとすると、影響範囲が大きすぎて工数が膨大になります。結果、準備に時間を取られ、導入自体が進まなくなる恐れがあります。
そこで有効なのが「出島的アプローチ」です。江戸時代、日本は鎖国政策の下で外国との交易を禁じていましたが、例外として長崎の出島だけは外国とつながる唯一の窓口となりました。完全に切り離された小さな島でありながら、そこから得た知見が日本全体に広がっていく。これをAI化に当てはめた考え方です。
例えば「契約変更」のような特定のコンタクトリーズンのみを切り出し、既存オペレーションとは分離した「AI専用の出島」として動かしてみる。
重要なのは、この出島を既存のプロセスと混ぜすぎないことです。独立した環境でAIオペレータを実運用することで、「このナレッジはAIが引き出せていない」「このヒアリングフローでは条件が足りない」という具体的な課題が浮かび上がります。AIオペレータを動かすことによって、AI-Readyなナレッジ管理の解像度を上げる。この循環こそが、出島アプローチの中核です。出島で積み上げた知見を横展開し、対象リーズンを少しずつ広げていくことが、スケーラブルなAI化への現実的な道筋です。
次に、ナレッジデータの管理設計について解説します。AI向けとオペレータ向けのナレッジを、1つのデータとして完全に一元管理しようとするのは現実的ではありません。
ポイントは「別々に持ちながら、ナレッジ間のつながりを管理する」という発想だと考えています。例えば、商品マニュアルが改定された際、それに紐づくオペレータ向けスクリプトとAI向けナレッジを同時に特定・更新できる仕組み(図2)があれば、多重管理のコストは大幅に抑制できます。元データと加工データ、AI向けと人向けのナレッジデータの「対応関係」を管理・保持しておくことで、更新の連鎖を管理できるのです。
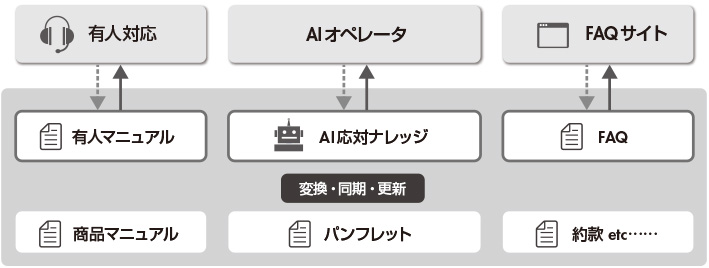
私たちが提供しているQANTでは、この考え方に基づき「QANT ナレッジハブ」を提供しています。AI向け・FAQ向け・オペレータ向けのナレッジを1つのプラットフォームで管理しながら、それぞれのデータのつながりを統合的に保持する。これにより、元データが変更された際に影響を受けるナレッジ(加工物)を特定し、更新を漏らさず反映することが可能になります。「目的ごとに適したナレッジをバラバラに持つが、そのつながりを管理する」、これがナレッジ多重管理の罠を解く設計思想です。
AIオペレータの応対品質は、構築時の設計だけでなく、運用開始後の管理でも左右されます。
裏を返すと、ナレッジ管理の設計に最初から真剣に向き合った組織は、AIオペレータの品質改善サイクルを持続的に回せるようになります。これは、顧客体験におけるAI実装がPoCで止まる組織と本番展開を成功させる組織の差でもあります。
第3回では、「AIオペレータ選定の6つのチェックポイント」を取り上げます。ベンダー選定で本当に差がつくのは、音声認識精度のような表面的スペックではなく「運用性」です。カスケード型とSTS(Speech-to-Speech)型の比較、ハルシネーションの3類型、そしてRFPに盛り込むべき評価項目を、実務ツールとして紹介します。
会員限定2026年09月20日 00時00分 公開
2026年09月20日 00時00分 更新
コールセンタージャパン 2026年10月号(9月20日発売)
特集「AIをまとった顧客」への備え情報過多時代の新たなカスタマージャー…

スキマ時間で声を変える! 毎日できるボイストレーニング
2026年10月号 <スキマ時間で声を変える! 毎日できるボイストレー…
秋竹朋子
元ファーストクラスCAの接客術“おもてなし力”の磨き方
2026年10月号 <元ファーストクラスCAの接客術 “おもてなし力”…
江上 いずみ
市界良好
2026年10月号 <市界良好>
秋山紀郎
AfterCall~電話の後で
2026年10月号 <AfterCall〜電話の後で>
山田祐嗣
千客万来 百鬼夜行
2026年10月号 <千客万来 百鬼夜行>
多和田 元

 新規登録
 ログイン